Modern bir web sitesinin içeriği çoğu zaman tarayıcıda, JavaScript çalıştıktan sonra oluşur: ürün listesi, fiyatlar, hatta sayfanın ana metni. Siz ekranda her şeyi gördüğünüz için Google’ın da gördüğünü varsayarsınız. Çoğu zaman doğru çıkar; ama bazen sayfa dizinlenir de içerik dizine girmez, başlık eksik kalır ya da bağlantılar hiç keşfedilmez. Sorunun sinsi tarafı, ekranda hiçbir hata görünmemesidir.
Bu yazıda Google’ın JavaScript’i nasıl işlediğini, sayfa kaynağıyla ekranda gördüğünüzün neden farklı olabileceğini ve bu farkı sayfa kaynağıyla beş dakikada nasıl kontrol edeceğinizi anlatıyoruz. Ardından yapay zekâ botları gibi JavaScript çalıştırmayabilen tarayıcıları ve sorun bulursanız yazılımcınıza hangi çözümleri sormanız gerektiğini ele alıyoruz. Teknik SEO’nun genel çerçevesi için teknik SEO rehberimize bakabilirsiniz.
Google JavaScript’i Nasıl İşler?
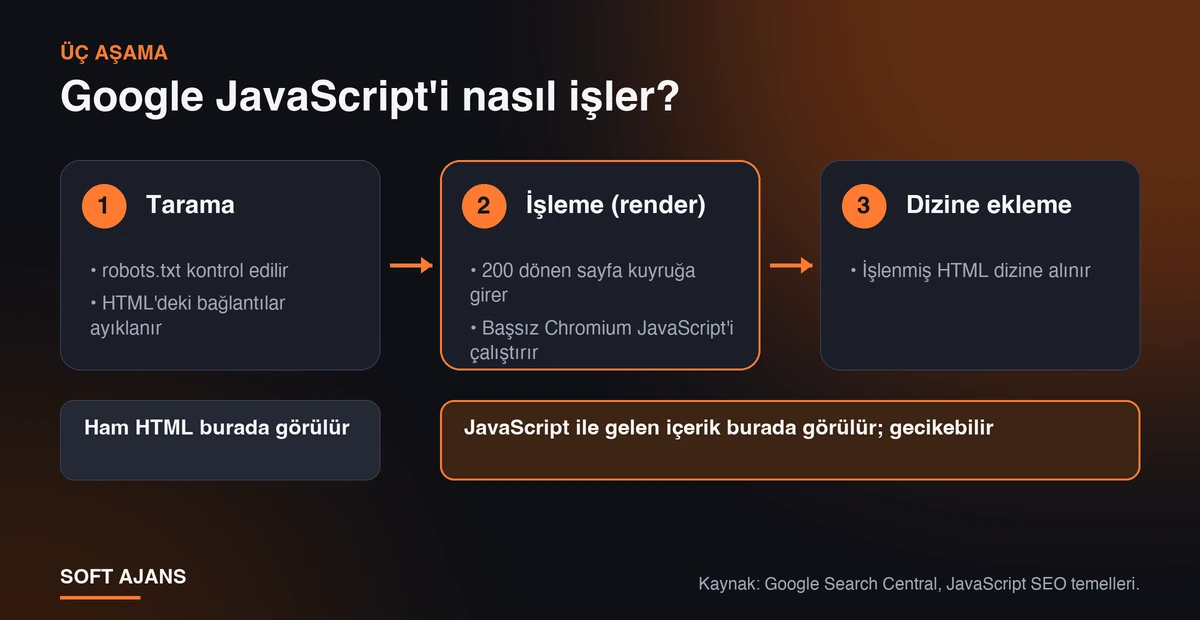
Google’ın JavaScript SEO temelleri belgesine göre JavaScript ile çalışan sayfalar üç aşamadan geçer:
- Tarama: Googlebot önce robots.txt’ye bakar; engellenmiş adresleri ve dosyaları işlemez. Ardından gelen HTML’deki bağlantıları ayıklar.
- İşleme (render): 200 durum koduyla dönen sayfalar işleme kuyruğuna alınır ve başsız bir Chromium tarayıcı JavaScript’i çalıştırır. Kuyrukta bekleme birkaç saniye sürebileceği gibi daha uzun da sürebilir.
- Dizine ekleme: Google işlenmiş HTML’i dizine ekler.
Kısacası Google JavaScript’i çalıştırabilir; ama bu “her şey sorunsuz görünür” anlamına gelmez. İşleme bir gecikme ve bir bağımlılık ekler: içeriğiniz bu aşamada tamamlanan bir betiğe bağlıysa, betik hata verdiğinde ya da engellendiğinde Google o içeriği geç görür ya da hiç göremez. Ham HTML’de hazır gelen içerik bu riskten bağımsızdır. Ayrıca Googlebot’un indirdiği her betik ve stil dosyası sitenizin tarama kapasitesinden pay alır; büyük sitelerde ağır JavaScript paketleri bu yüzden tarama sıklığını da etkileyebilir (ayrıntı için tarama bütçesi rehberimize bakın). Bu yüzden amaç “JavaScript kullanmamak” değil, önemli içeriğin ilk yanıtta da bulunmasıdır.
Sayfa Kaynağı ile Ekranda Gördüğünüz Neden Farklıdır?
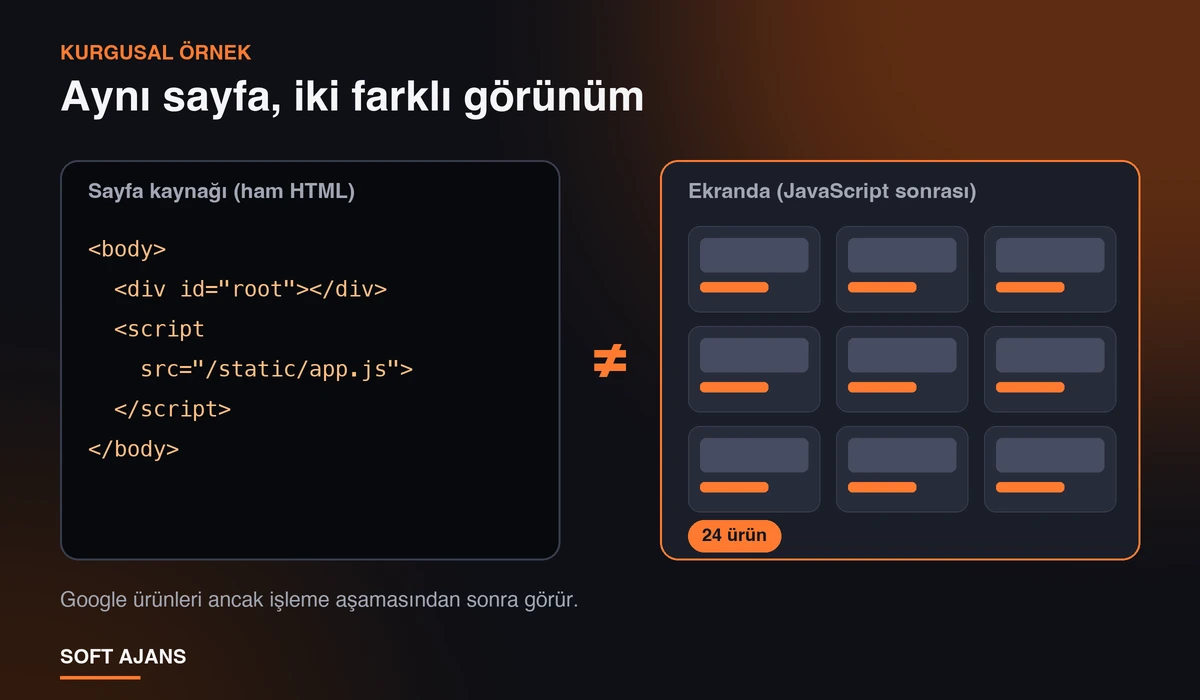
“Sayfa kaynağını görüntüle” (Windows’ta Ctrl+U, Mac’te Cmd+Option+U) sunucunun gönderdiği ham HTML’i gösterir. Tarayıcıdaki “İncele” paneli ise JavaScript çalıştıktan sonraki güncel yapıyı gösterir. İki görünüm arasındaki fark, içeriğin nereden geldiğini söyler. İstemci tarafında oluşturulan bir ürün listesinin kaynağı kurgusal olarak şuna benzeyebilir:
<body>
  <div id="root"></div>
  <script src="/static/app.js"></script>
</body>
Ekranda 24 ürün görünür, kaynakta ise boş bir kap ve bir betik vardır. Google ürünleri ancak işleme aşamasından sonra görür. Farkın tipik kaynakları şunlardır:
- Sayfanın tamamını tarayıcıda oluşturan istemci tarafı render (CSR) yapıları,
- “Daha fazla yükle” ve sonsuz kaydırma gibi etkileşimle gelen içerik,
- Sekme ve akordeon gibi tıklamayla açılan, içeriğini sonradan getiren bölümler,
- Bir API’den çekilip sayfaya yazılan fiyat, stok ve yorum bilgileri.
Bunlar tek başına hata değildir; ama önemli metnin ve bağlantıların hangi gruba girdiğini bilmek gerekir.
5 Dakikada Kontrol: Sayfa Kaynağı Adım Adım
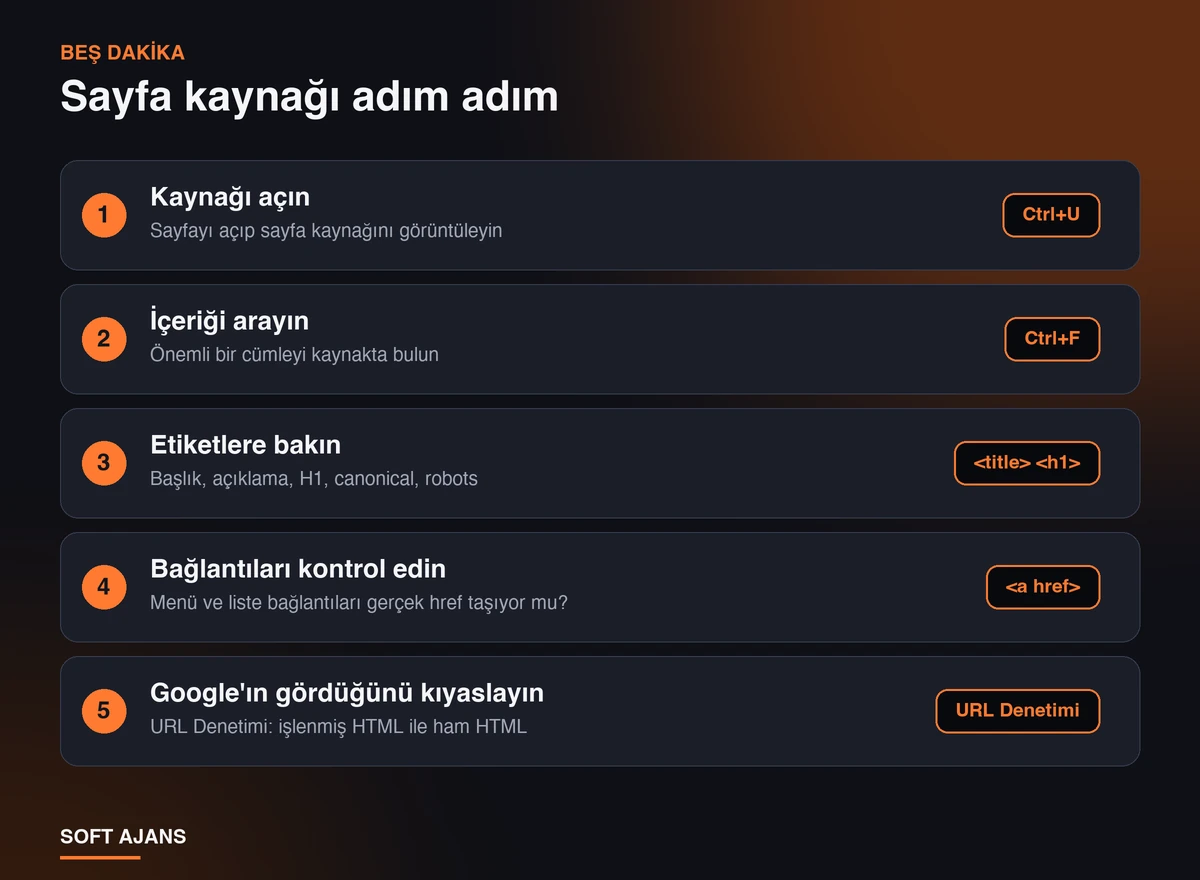
Kontrol için geliştirici bilgisi gerekmez. Önemli bir sayfanızı (ana sayfa, bir kategori, bir ürün ya da hizmet sayfası) seçip şu adımları izleyin:
- Kaynağı açın. Sayfayı tarayıcıda açıp sayfa kaynağını görüntüleyin.
- İçeriği arayın. Sayfadaki önemli bir cümleyi ya da ürün adını Ctrl+F ile kaynakta arayın. Bulamıyorsanız o içerik JavaScript ile geliyor demektir.
- Etiketlere bakın.
<title>, meta açıklama,<h1>, canonical ve robots meta etiketlerinin kaynakta bulunduğunu ve doğru değerleri taşıdığını doğrulayın. - Bağlantıları kontrol edin. Menü ve kategori bağlantılarının kaynakta
<a href="...">olarak yer aldığına bakın. - Google’ın gördüğünü karşılaştırın. Search Console’da URL Denetimi ile canlı URL’yi test edip işlenmiş HTML’e bakın; arayüz adları zamanla değişebilir, ama amaç Google’ın işlemeden sonra gördüğü sürümü ham HTML ile kıyaslamaktır.
Sonucu nasıl yorumlarsınız?
- Metin kaynakta var: Risk düşük. Sayfa ilk yanıtta eksiksiz geliyor.
- Metin kaynakta yok ama işlenmiş HTML’de var: Orta risk. Google içeriği görebilir, ancak işleme gecikmesiyle; JavaScript çalıştırmayan botlar ise göremez.
- Metin ikisinde de yok: Yüksek risk. Betik hata veriyor, engelleniyor ya da içerik kullanıcı etkileşimine bağlı olabilir; geliştiricinizle birlikte inceleyin.
İlk dört adımı elle yapmak yerine kaynağı Sayfa Kaynağı SEO Denetleyici aracımıza yapıştırabilirsiniz. Araç başlık, açıklama, H1, canonical, robots meta, yapılandırılmış veri, görsel alt metinlerini ve bağlantıları denetler; kaynakta çok az metin görünüyorsa içeriğin JavaScript ile yüklenmiş olabileceği konusunda uyarır. Yapıştırdığınız metin tarayıcınızda işlenir, hiçbir yere gönderilmez.
Hangi JavaScript Sorunları Gerçekten Risklidir?
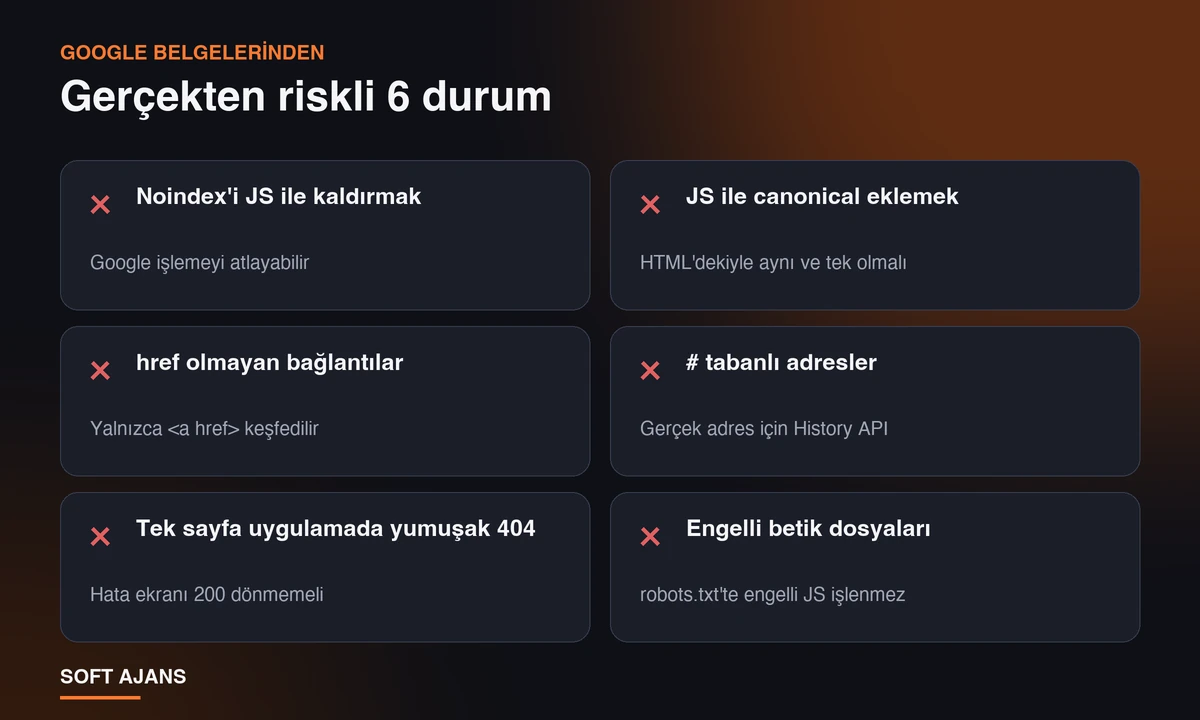
Her JavaScript kullanımı sorun değildir. Google’ın belgelerinde öne çıkan riskler şunlardır:
- Noindex’i JavaScript ile kaldırmak: Google
noindexgördüğünde işlemeyi atlayabilir; bu yüzden etiketi sonradan betikle silmek işe yaramayabilir. Sayfanın dizinlenmesini istiyorsanız ilk HTML’de noindex bulunmamalıdır. - Canonical’ı JavaScript ile eklemek: HTML tercih edilen yöntemdir. Betikle ekleniyorsa HTML’deki ile aynı olmalı ve tek canonical bulunmalıdır. Konunun temelini canonical URL rehberimizde anlattık.
<a href>olmayan bağlantılar: Google yalnızcahrefiçeren<a>öğelerini bağlantı olarak keşfeder. Tıklama olayıyla çalışan düğmeler sayfa keşfini engelleyebilir.#tabanlı adresler:site.com/#/urunlergibi adres parçalarıyla yapılan gezinme güvenilir değildir; gerçek adresler için History API kullanılmalıdır.- Tek sayfa uygulamalarda yumuşak 404: Olmayan sayfa 200 dönerse hata sayfası dizine girebilir. Gerçek 404 döndürülemiyorsa 404 adresine yönlendirme ya da hata ekranında noindex gerekir.
- Engellenmiş betik dosyaları: robots.txt ile engellenen JavaScript dosyaları işlenmez. Robots.txt rehberimiz kuralların nasıl yazılacağını gösterir.
Ayrıca Googlebot sayfada kullanıcı gibi tıklamaz; yalnızca tıklayınca ya da kaydırınca yüklenen içerik garanti edilmez. Filtreli e-ticaret sayfalarında bu konu ayrıca önem kazanır; ayrıntı için filtreli kategori sayfaları yazımıza bakın.
Hangi Sayfalarda Sorun Daha Sık Görülür?
Aynı sitede bazı şablonlar sorunsuz, bazıları sorunlu olabilir; bu yüzden denetimi tek sayfayla sınırlamayın. Deneyimle en sık şu yerlerde karşılaşılır:
- Kategori ve ürün listeleri: Ürün kartları bir API’den çekiliyor ve istemcide çiziliyorsa ham HTML’de ürün bağlantısı bulunmaz. “Daha fazla yükle” düğmesi yerine gerçek sayfalama bağlantıları kullanın.
- Üçüncü taraf yorum ve soru-cevap araçları: Bu bileşenler içeriği çoğunlukla betikle getirir; yorum metinlerinin sizin sayfanızın ham HTML’inde bulunacağını varsaymayın.
- Sekme ve akordeon alanları: İçerik HTML’de duruyor ve yalnızca gizleniyorsa genellikle sorun olmaz; tıklayınca sunucudan getiriliyorsa risklidir.
- Tek sayfa uygulama olarak yazılmış kurumsal siteler: Hizmet, hakkımızda ve iletişim sayfalarının hepsi tek bir betikle çiziliyorsa tüm site aynı riski taşır.
- Dil ve bölge değiştirme: Dil seçimi betikle yapılıyorsa dil sürümlerinin ayrı ve taranabilir adresleri olduğundan emin olun.
Yapay Zekâ Botları JavaScript Çalıştırır mı?
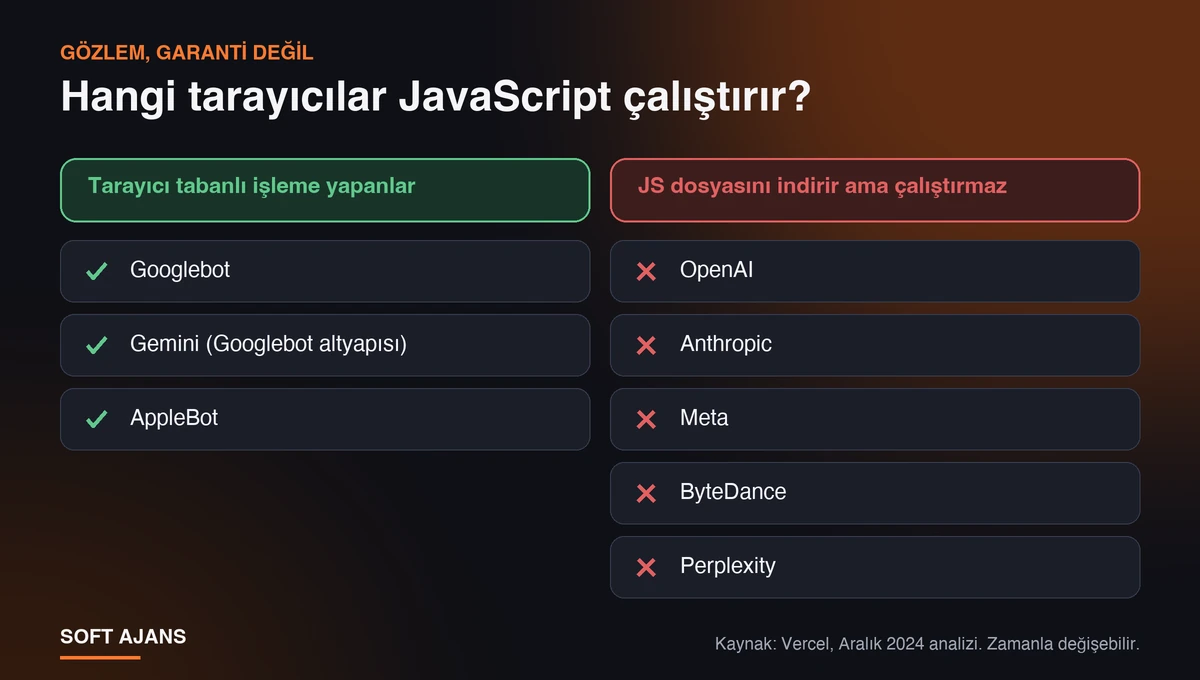
Google dışındaki tarayıcılar için tablo daha az rahattır. Google’ın belgesi de her botun JavaScript çalıştıramadığını hatırlatıyor ve hız ile tarayıcı uyumluluğu için sunucu tarafı ya da önceden oluşturulmuş HTML’i öneriyor. Vercel’in Aralık 2024’te yayımladığı yapay zekâ tarayıcıları analizi, büyük yapay zekâ tarayıcılarının (OpenAI, Anthropic, Meta, ByteDance ve Perplexity) JavaScript dosyalarını indirdiğini ama çalıştırmadığını; Googlebot’un (ve onun altyapısını kullanan Gemini’nin) ve AppleBot’un ise tarayıcı tabanlı işleme yaptığını bildirdi.
Bu bir gözlemdir ve zamanla değişebilir; kendi sunucu kayıtlarınızı ve botların güncel belgelerini de kontrol edin. Yine de pratik sonuç nettir: ChatGPT, Claude ya da Perplexity gibi yanıt motorlarında markanızın görünmesini istiyorsanız ana metin, ürün bilgisi ve fiyat gibi alıntılanabilecek içerik ham HTML’de bulunmalıdır. Bu alanı GEO rehberimizde, botlara verdiğiniz izinleri ise robots.txt yapay zekâ bot denetleyicimizde inceleyebilirsiniz. Genel durumunuzu görmek için yapay zekâ görünürlük testini de deneyebilirsiniz.
Sorun Bulursanız Hangi Çözümler Var?
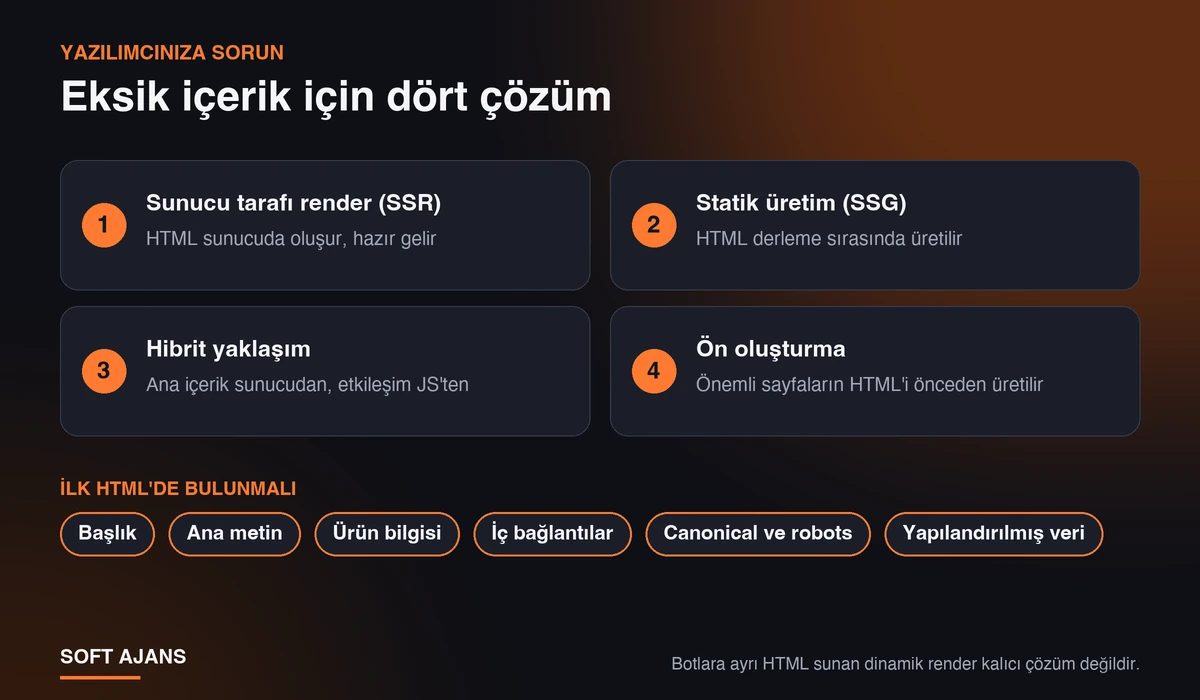
Kaynakta eksik içerik bulduysanız siteyi baştan yazmanız gerekmeyebilir; önce hangi şablonların (ana sayfa, kategori, ürün, blog) etkilendiğini ölçün, ardından en çok trafik ve satış getiren şablondan başlayın. Yazılımcınıza şu seçenekleri sorun:
- Sunucu tarafı render (SSR): HTML sunucuda oluşturulur ve tarayıcıya hazır gelir. İçeriği sık değişen sayfalar için uygundur.
- Statik üretim (SSG): HTML derleme sırasında üretilir. Blog, hizmet ve kategori gibi nadir değişen sayfalarda hızlı ve güvenilir bir seçenektir. Headless CMS rehberimizde bu mimarinin yapı taşlarını anlattık.
- Hibrit yaklaşım: Başlık, ana metin ve bağlantılar sunucudan gelir; etkileşimli kısımlar JavaScript ile eklenir.
- Ön oluşturma (prerendering): Önemli sayfaların HTML sürümü önceden üretilir. Botlara ayrı HTML sunan “dinamik render” ise Google tarafından kalıcı çözüm olarak önerilmiyor.
Yazılımcınıza şu dört soruyu iletmek konuşmayı hızlandırır:
- Sayfa ilk yanıtta başlık, ana metin ve ürün bilgisini içeriyor mu?
- Menü ve liste bağlantıları gerçek
hreftaşıyor mu? - noindex, canonical ve robots etiketleri sunucudan mı geliyor, betikle mi ekleniyor?
- Olmayan bir adres gerçekten 404 döndürüyor mu?
Öncelik sırası basittir: başlık, ana metin, ürün bilgisi, iç bağlantılar, canonical, robots etiketi ve yapılandırılmış veri ilk HTML’de bulunsun; kişiselleştirilmiş ve etkileşimli kısımlar JavaScript’te kalabilir. Ayrıca JavaScript yüklemesinin Core Web Vitals sonuçlarını da etkilediğini unutmayın.
Sık Yapılan Hatalar
- Ekranda görünüyor diye sorun olmadığını varsaymak: Kaynakla ekran arasındaki farkı hiç kontrol etmemek.
- Yalnızca bir sayfa tipini denemek: Ana sayfa sorunsuz olabilir, kategori ve ürün şablonları bozuk olabilir.
- Bağlantıları düğmeyle kurmak: Menüde
hrefyoksa alt sayfalar keşfedilmez. - noindex ve canonical’ı betikle yönetmek: İlk HTML ile işlenmiş HTML çelişirse hangi sinyalin kazanacağı belirsizleşir.
- Düzeltmeden sonra yeniden test etmemek: Değişikliği canlıda kaynakla ve Search Console ile doğrulayın.
Soft Ajans Teknik SEO’da Neler Yapıyor?
Teknik SEO denetiminde robots.txt, sitemap, canonical, yönlendirme ve durum kodlarını inceler; Google’ın hangi sayfaları gördüğünü, hangilerini dışarıda bıraktığını Search Console verisiyle ortaya çıkarırız. Bulguları etkisine göre sıralar, düzeltmeleri isterseniz biz uygular, isterseniz yazılımcınıza net yönergelerle ileticiniz. Denetimde önemli şablonlarınızı (ana sayfa, kategori, ürün ya da hizmet sayfası) tek tek ele alırız. Hiçbir sıralama ya da trafik garantisi vermeyiz; neyi neden önerdiğimizi baştan yazarız. Ayrıntılar için teknik SEO hizmeti sayfamıza bakabilir, kontrol listesi olarak SEO kontrol listemizi kullanabilirsiniz. Mağazanız için filtre ve parametre yönetimi gerekiyorsa e-ticaret SEO hizmetimiz bunu kapsar.
Sık Sorulan Sorular
Google JavaScript ile yüklenen içeriği dizine ekler mi?
Çoğu durumda evet; Google sayfaları işleyip JavaScript’i çalıştırır. Ancak bu bir kuyruğa ve betiğin sorunsuz çalışmasına bağlıdır, bu yüzden önemli içeriğin ilk HTML’de de bulunması daha güvenlidir.
Sayfa kaynağında içerik yoksa Google göremez mi?
Ham HTML’de yoksa Google içeriği ilk aşamada görmez; işleme sonrasında görebilir. Görünürlük gecikebilir ya da betik hatasında hiç oluşmayabilir. Diğer botlar ise çoğunlukla bu ikinci aşamayı yapmaz.
React, Vue ya da Angular siteleri SEO’ya uygun mu?
Uygun olabilir. Sunucu tarafı render ya da statik üretimle önemli içerik ilk HTML’e yazılırsa sorun yoktur. Yalnızca tarayıcıda oluşturulan yapılar daha fazla dikkat ve test gerektirir.
URL Denetimi’nde içerik görünüyor ama kaynakta yok, sorun var mı?
Google işlenmiş sayfayı görüyorsa dizinleme mümkündür. Yine de yapay zekâ botları gibi JavaScript çalıştırmayan tarayıcılar o içeriği göremeyebilir; önemli metinler için ham HTML’de bulunmasını hedefleyin.
Yapay zekâ botları JavaScript çalıştırır mı?
Büyük yapay zekâ tarayıcıları için yapılan bağımsız bir analiz, bunların JavaScript dosyalarını indirdiğini ama çalıştırmadığını bildirdi. Bu bir gözlemdir ve değişebilir; alıntılanmasını istediğiniz içeriği ham HTML’e koymak güvenlidir.
Tıklayınca ya da kaydırınca yüklenen içeriği Google görür mü?
Googlebot kullanıcı gibi tıklamaz; bu tür içerik garanti edilmez. Dizinlenmesini istediğiniz metin ve bağlantıları sayfa yüklenirken HTML’de bulundurun.